La evolución de la robótica ha alcanzado un punto de inflexión gracias a la convergencia de la visión computacional y el procesamiento de lenguaje natural. Para la comunidad Maker, apasionada por la innovación y el «hazlo tú mismo», la llegada de los modelos VLA (Vision-Language-Action) representa el «cerebro» que faltaba para que nuestras creaciones dejen de ejecutar rutas preprogramadas y empiecen a entender el mundo real.
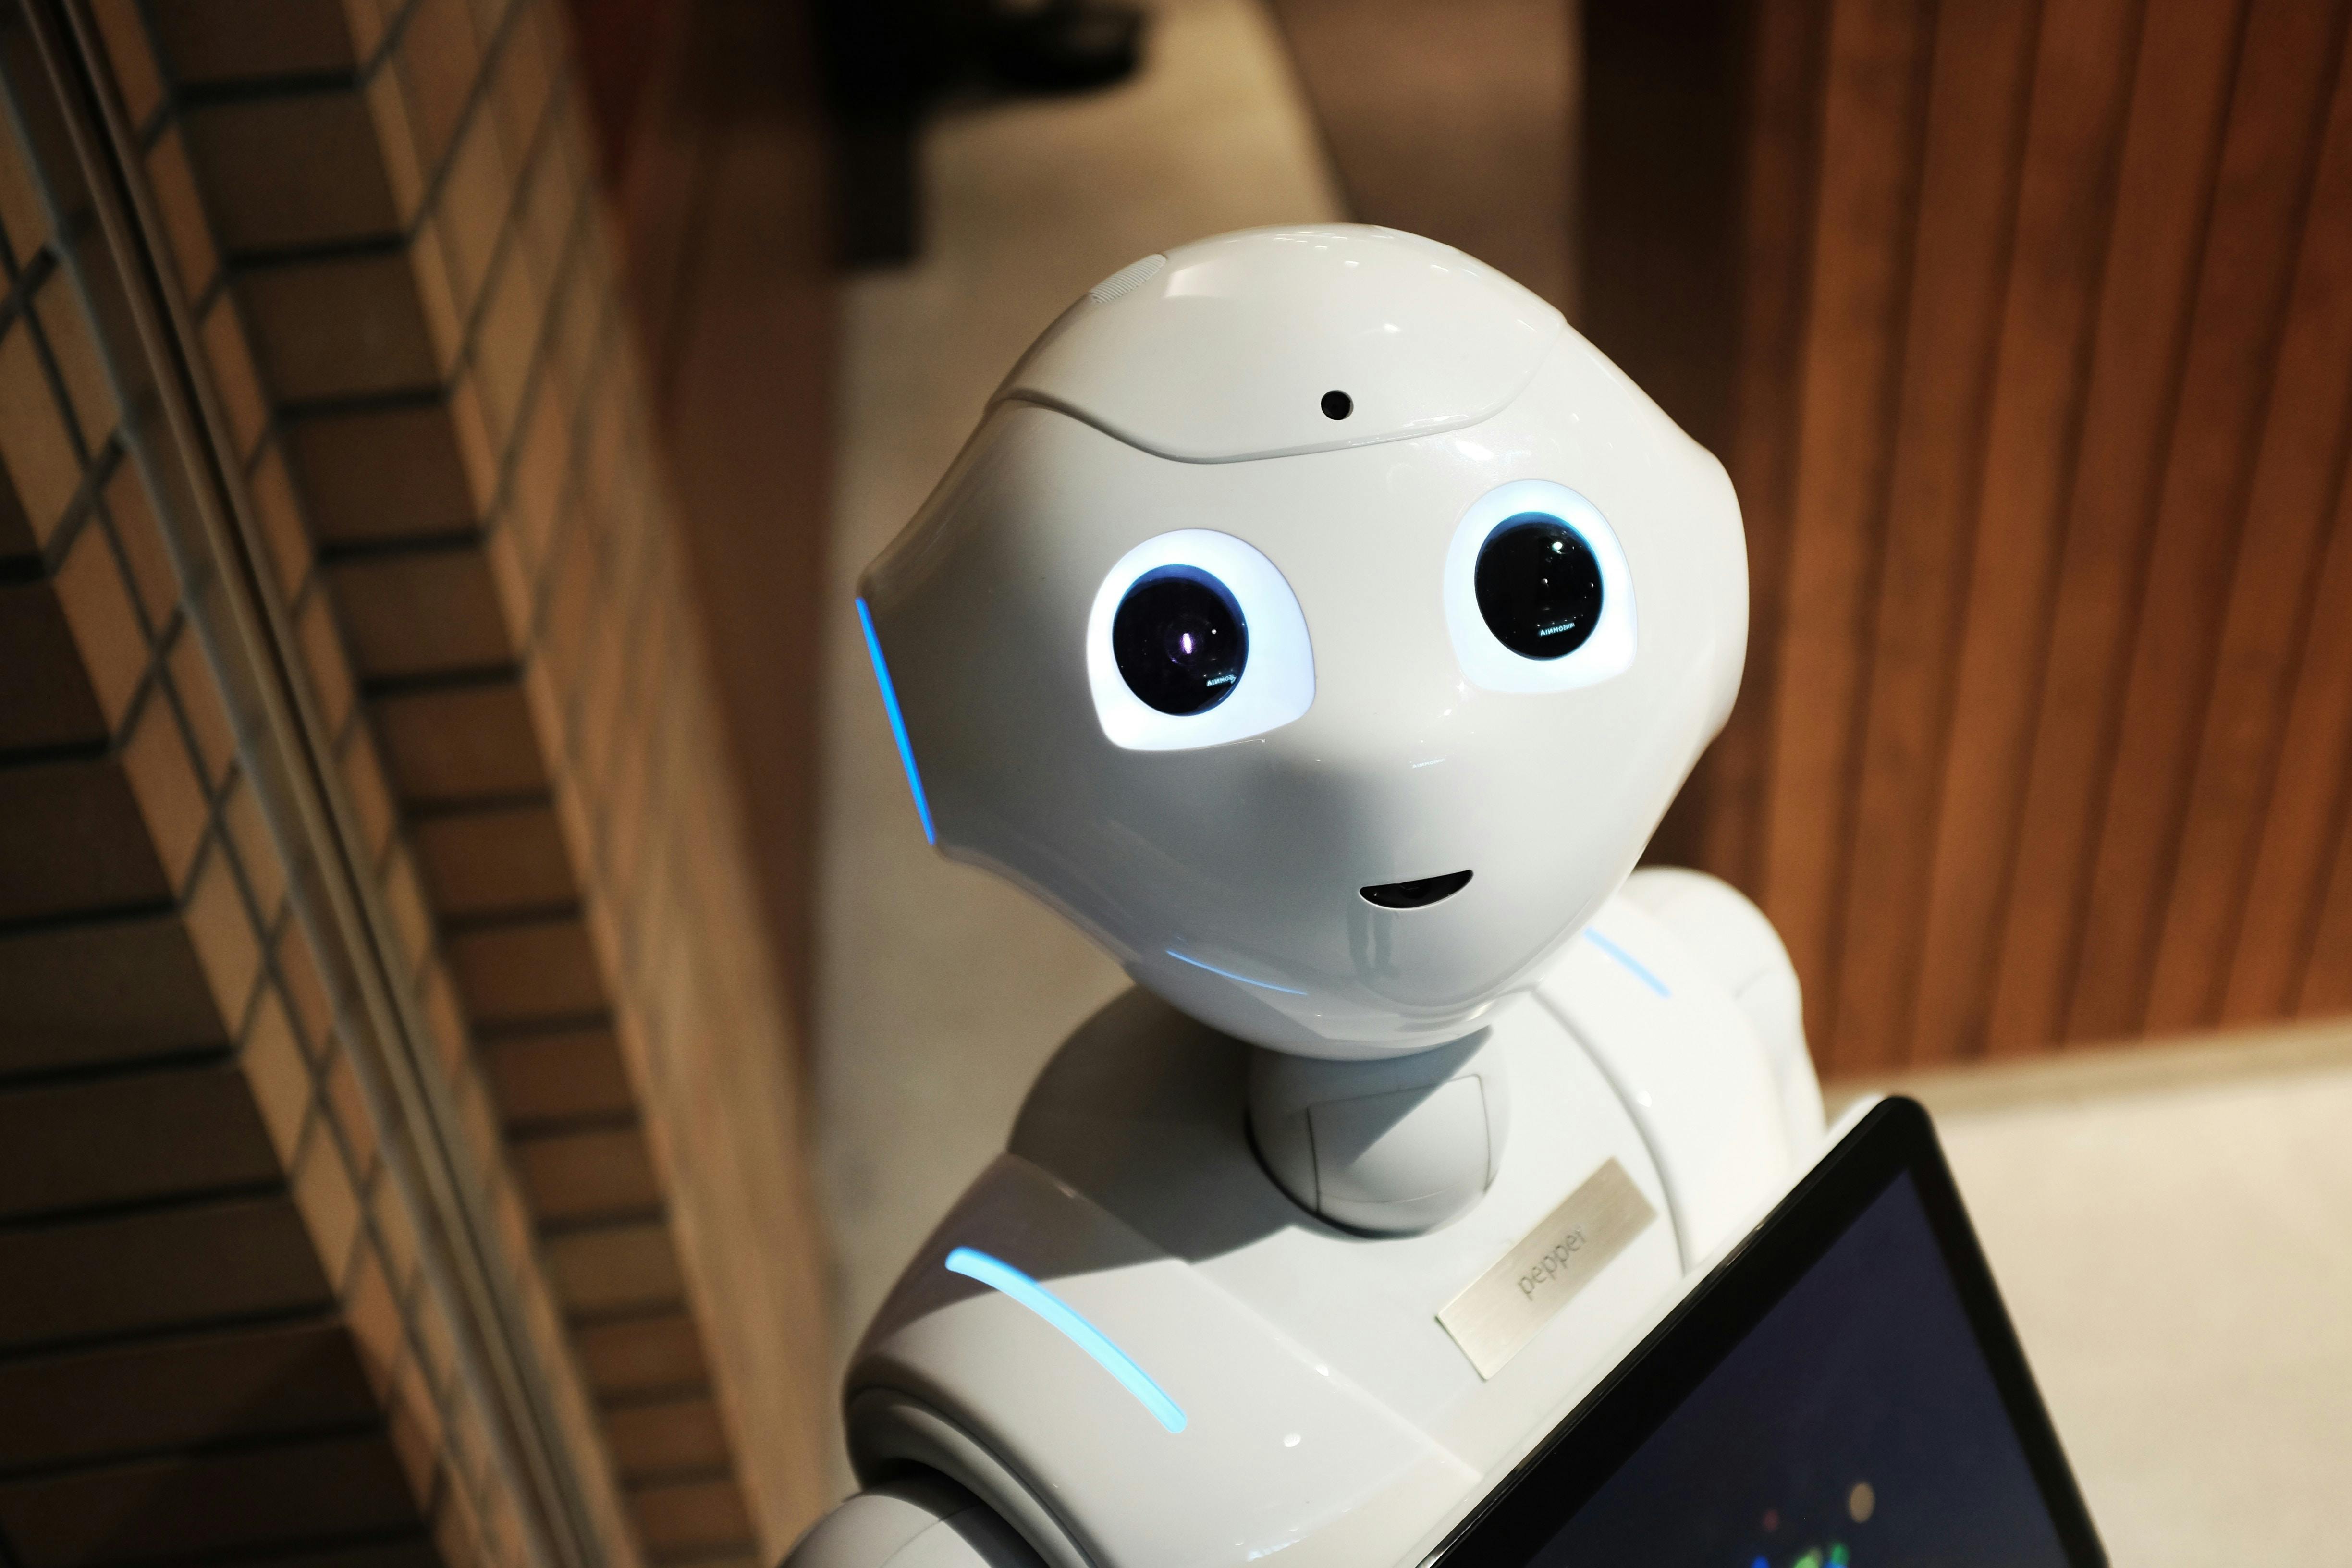
Los modelos vla robotica se basan en una premisa revolucionaria: un solo modelo neuronal puede procesar imágenes (visión), instrucciones en texto (lenguaje) y convertirlas directamente en movimientos motores (acción). A diferencia de los sistemas tradicionales, donde cada tarea requería un código específico, estos modelos permiten que los robots humanoides inteligencia artificial realicen tareas complejas, como «recoger la manzana roja y ponerla en la cesta», sin haber sido programados explícitamente para esa fruta o esa cesta en particular.
El aprendizaje por demostración: La clave del entrenamiento
Uno de los pilares que sostiene esta tecnología, y que ha sido ampliamente documentado en publicaciones de prestigio como la IEEE Robotics & Automation Magazine, es el aprendizaje por demostracion. En lugar de escribir miles de líneas de código para definir las coordenadas de una pinza, los desarrolladores «enseñan» al robot mostrándole ejemplos. El modelo VLA observa el video de un humano realizando la tarea, escucha la instrucción verbal y correlaciona los píxeles con el movimiento necesario.
Para los entusiastas que buscan llevar sus proyectos al siguiente nivel, entender estos flujos es vital. Si quieres profundizar en cómo implementar estas tecnologías en tus propios prototipos, te recomendamos visitar Robótica Online, donde encontrarás recursos actualizados sobre el sector.

Robots Humanoides: Entendiendo el contexto
La aplicación más ambiciosa de estos avances se da en la robótica humanoide. Un robot con forma humana necesita una coordinación excepcional para manipular herramientas diseñadas para nosotros. Gracias a los modelos VLA, estos robots pueden generalizar comportamientos. Si un robot aprende a abrir una puerta con una manilla redonda, el modelo le permite deducir cómo abrir una puerta con una palanca, simplemente ajustando su visión y acción bajo la instrucción de lenguaje natural: «abre la salida».
Este enfoque reduce drásticamente la barrera de entrada para la creación de robots de asistencia. Ya no es necesario ser un experto en cinemática inversa avanzada; ahora, el enfoque se desplaza hacia la recolección de datos de calidad y el ajuste fino de modelos fundacionales. El futuro de la comunidad Maker está en integrar estos modelos en hardware de código abierto, permitiendo que un brazo robótico impreso en 3D entienda comandos de voz complejos mientras observa su entorno mediante una cámara estándar.
En conclusión, los modelos VLA están democratizando la inteligencia física. La capacidad de unir visión, lenguaje y acción en una sola arquitectura está transformando a los robots de simples máquinas automáticas a compañeros capaces de entender y actuar. Mantente al día de todas estas novedades en https://www.roboticaonline.es y empieza a construir el futuro hoy mismo.